Quy trình làm video cưới bằng AI
Tác giả bắt gặp một video cưới làm bằng AI lan truyền mạnh trên Internet và nhận ra đây có thể là một mô hình kinh doanh AI khá tốt, đặc biệt vì bản thân có người thân làm trong ngành cưới. So với các dịch vụ như Custom Love Story chủ yếu làm hoạt hình, tác giả xây dựng một quy trình tạo video cưới theo hướng **người thật**, sử dụng ảnh thật của cô dâu chú rể làm ảnh tham chiếu để tái hiện câu chuyện tình yêu.
Tóm tắt
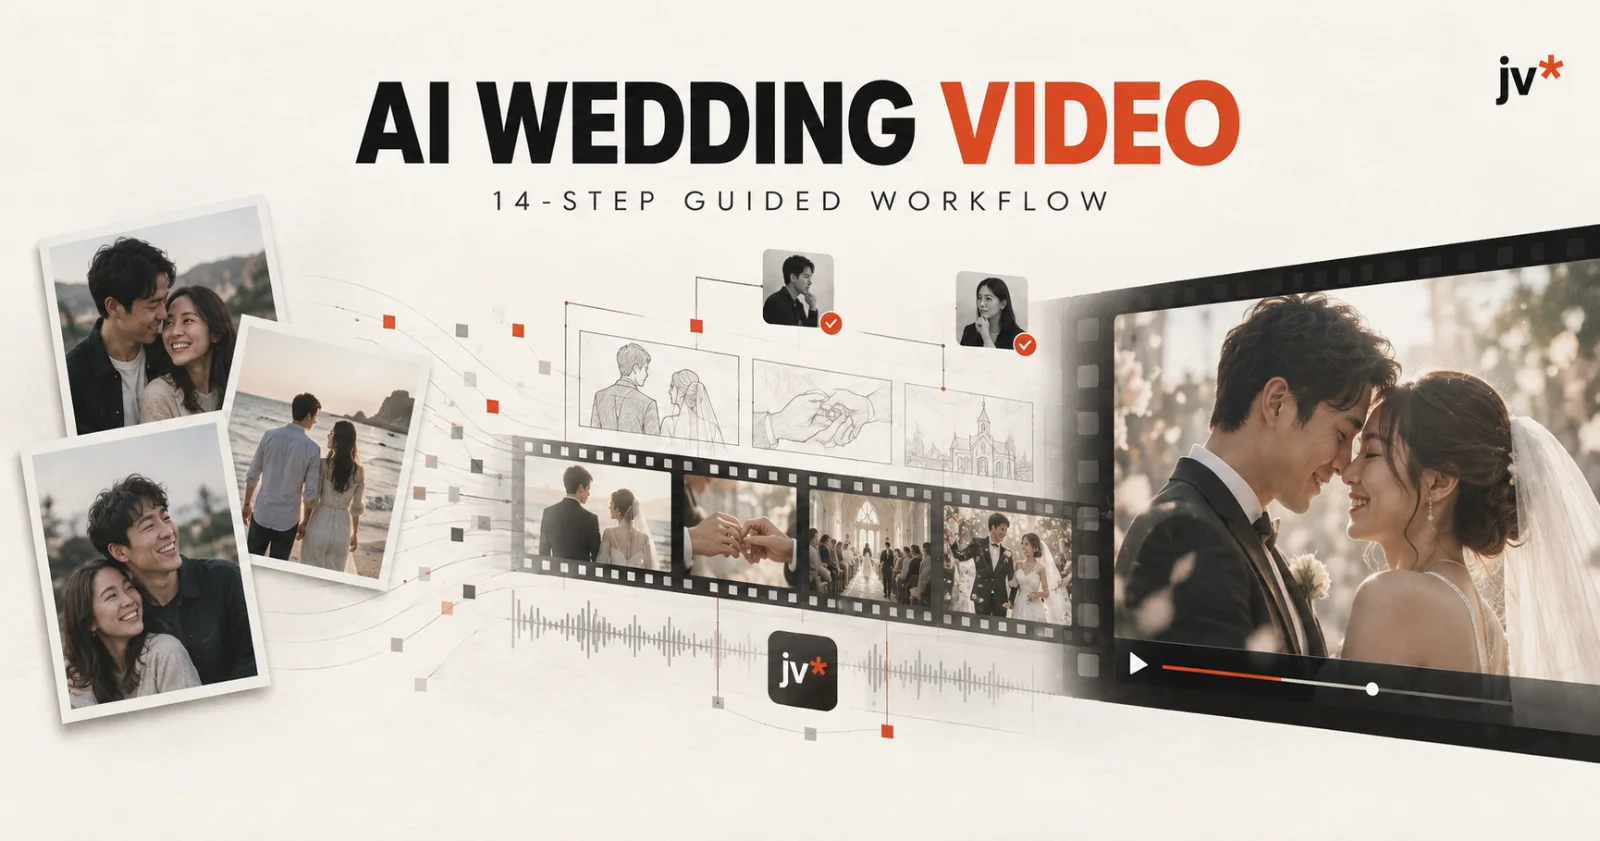
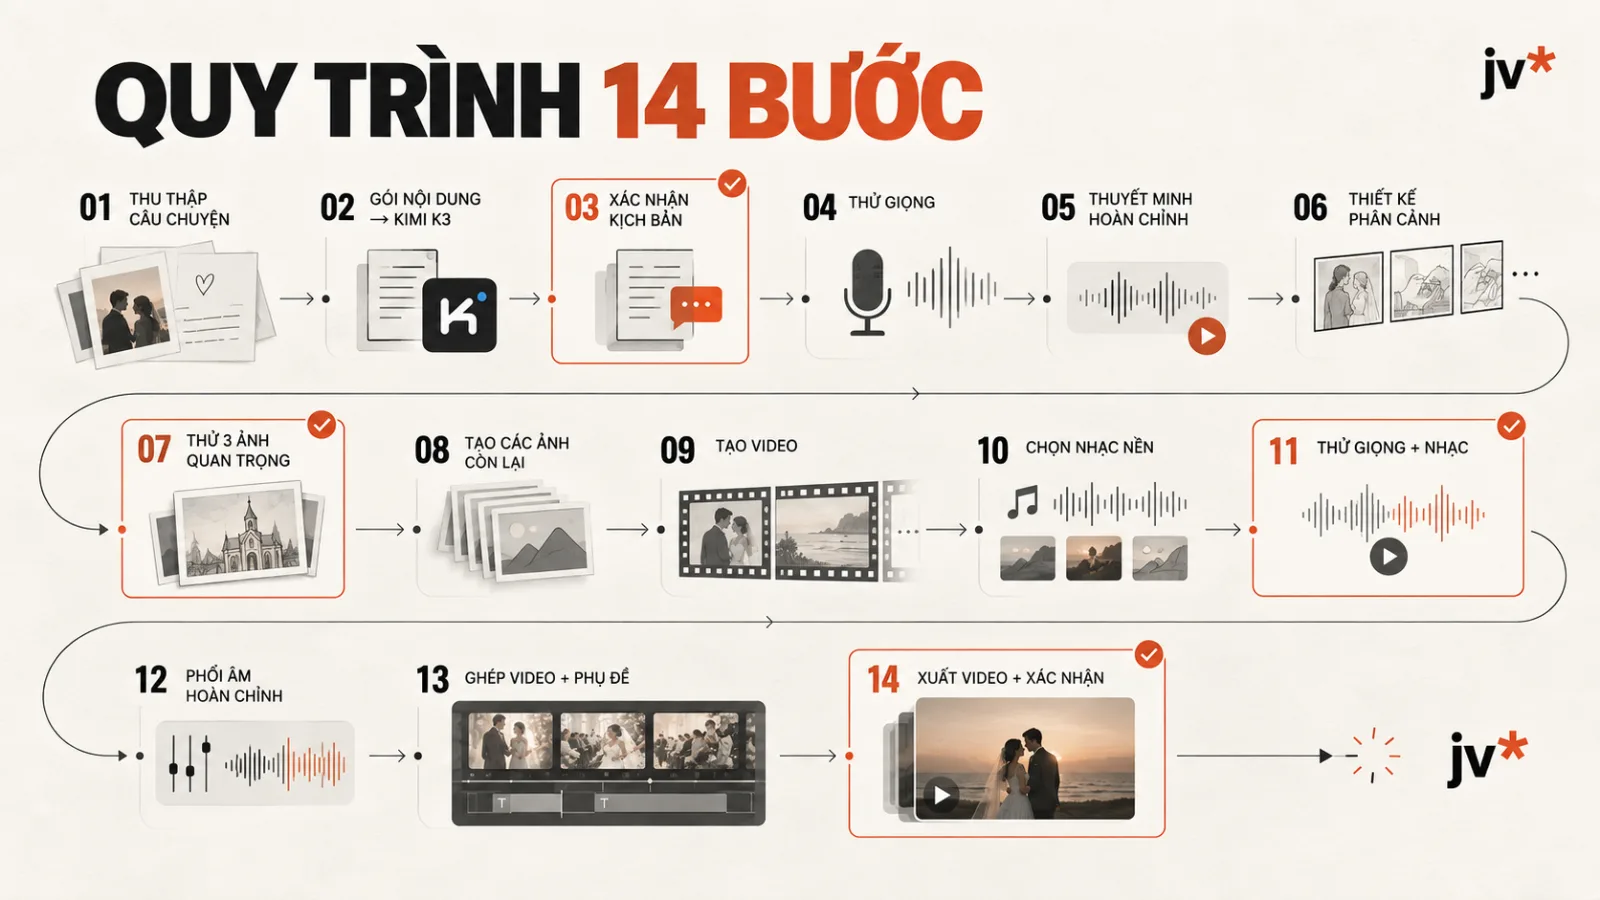
Toàn bộ quy trình được đóng gói thành một Skill có hướng dẫn gồm 14 bước, từ thu thập câu chuyện → viết kịch bản → khách hàng duyệt → TTS → phân cảnh → tạo ảnh → tạo video → nhạc nền → phối âm → phụ đề → xuất thành phẩm. Skill luôn cho biết đang ở bước nào, còn bao nhiêu bước và tiếp theo cần làm gì; những chỗ cần con người đánh giá sẽ dừng lại chờ xác nhận.
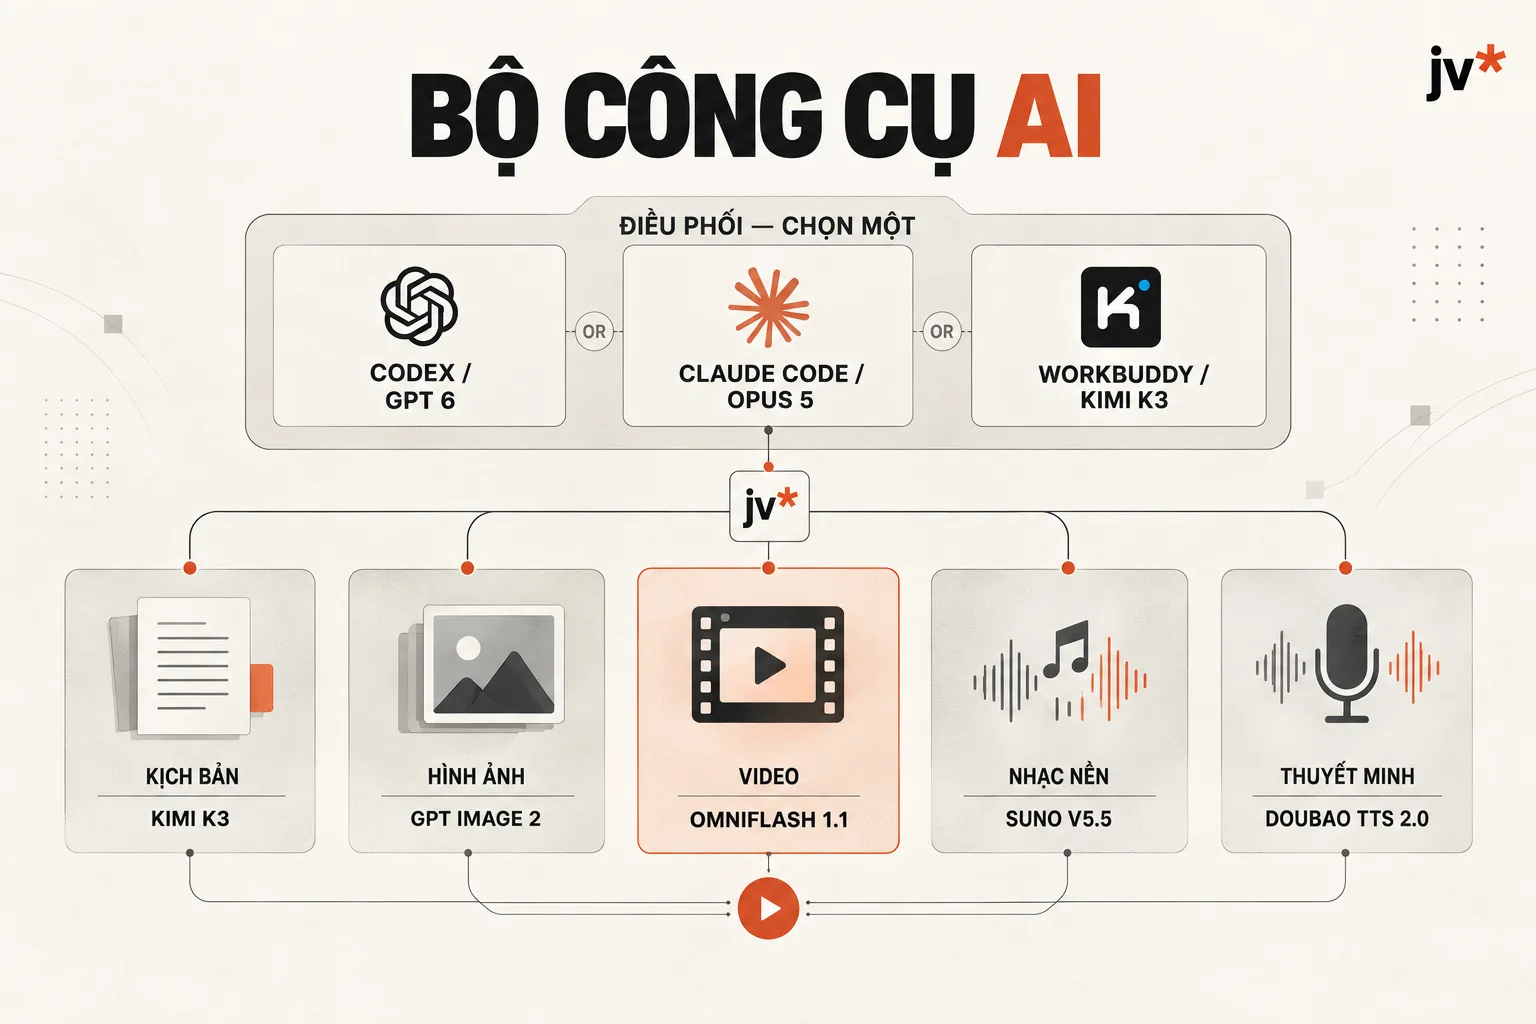
Bộ công cụ tác giả đề xuất:
Điều phối toàn bộ quy trình: Codex GPT 6 / Claude Code Opus 5 / chế độ mạnh nhất của Kimi K3 trong WorkBuddy.
Viết kịch bản: đặc biệt khuyên dùng Kimi K3.
Tạo ảnh: GPT Image 2.
Tạo video: OmniFlash 1.1, được xem là thành phần cốt lõi.
Nhạc nền: Suno V5.5.
Thuyết minh: Doubao TTS 2.0.
Điểm tác giả tập trung tối ưu nhất là thời gian giao tiếp và công sức thủ công, chứ không phải chi phí sử dụng model. Vì vậy tác giả tạo một “phiếu thu thập câu chuyện” để khách hàng điền toàn bộ thông tin ngay từ đầu, giảm việc hỏi đi hỏi lại. Sau đó Skill sử dụng dữ liệu này xuyên suốt toàn bộ quy trình sản xuất.
Theo tác giả, với API trung gian giá rẻ, một video khoảng 2 phút có thể có chi phí tạo nội dung khoảng 11–15 RMB, phần lớn nằm ở khâu tạo video. Nếu đã có Gemini Pro và sử dụng credit của Google Flow, chi phí phát sinh có thể gần như bằng 0. Tác giả cho biết sau khi vận hành trơn tru quy trình, tổng thời gian con người phải trực tiếp can thiệp có thể được kiểm soát dưới khoảng 1 giờ cho mỗi đơn.
Quy trình cụ thể gồm:
Gửi phiếu thu thập câu chuyện cho cặp đôi.
Dùng thông tin đó tạo gói nội dung viết và đưa cho Kimi K3.
Gửi kịch bản cho khách hàng duyệt.
Thử 3–5 giọng TTS.
Tạo và kiểm tra toàn bộ phần thuyết minh.
Thiết kế phân cảnh dựa trên kịch bản và thời lượng giọng đọc thực tế.
Thử tạo ảnh với 3 cảnh khó hoặc quan trọng trước.
Tạo toàn bộ ảnh còn lại.
Dùng từng ảnh làm khung hình đầu để tạo video từ ảnh.
Tạo khoảng 3 phong cách nhạc nền để lựa chọn.
Thử phối nhạc nền và giọng đọc trên một vài đoạn.
Xuất toàn bộ bản phối âm thanh.
Ghép video, giọng đọc, nhạc nền và phụ đề.
Xuất video hoàn chỉnh và gửi khách hàng duyệt.
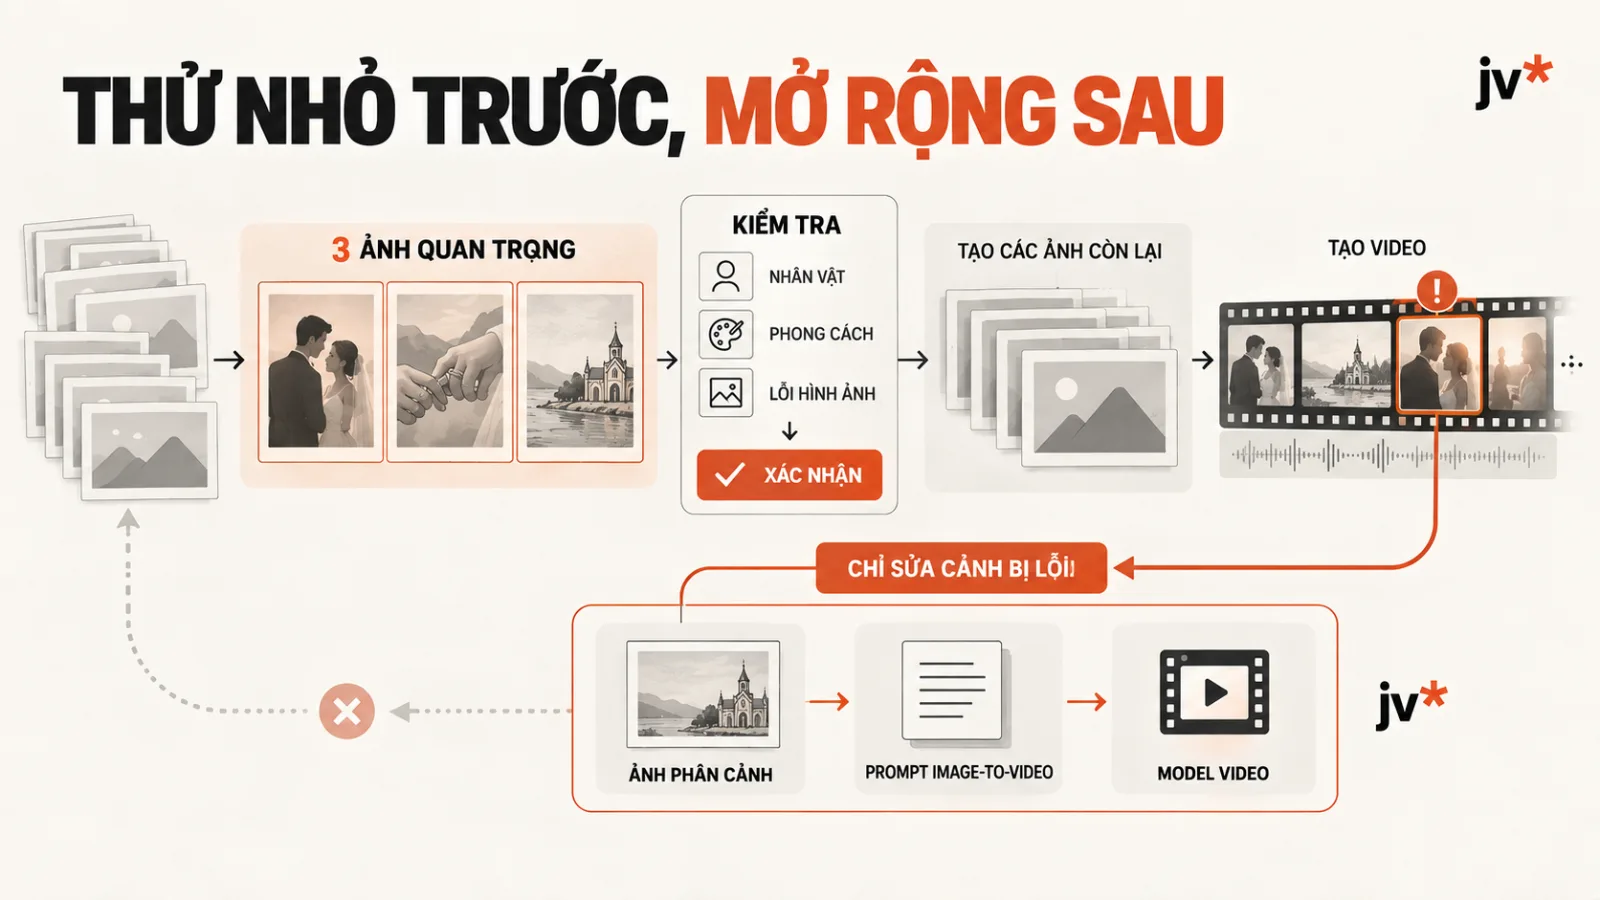
Một nguyên tắc quan trọng là không tạo tất cả ngay lập tức. Quy trình liên tục sử dụng các điểm kiểm tra nhỏ: duyệt kịch bản trước khi làm giọng đọc; duyệt giọng đọc trước khi làm phân cảnh; thử 3 ảnh trước khi tạo toàn bộ; kiểm tra từng cảnh video; thử nhạc nền và bản phối trên đoạn ngắn trước khi xuất toàn bộ. Cách này giảm việc “抽卡” — phải tạo đi tạo lại nhiều lần để cầu may.
Tác giả cũng giải thích vì sao sử dụng thuyết minh thay vì để nhân vật trực tiếp nói tiếng Trung: Omni có chi phí và chất lượng hình ảnh tốt nhưng khả năng tạo hội thoại tiếng Trung chưa đủ ổn định. Tách phần giọng nói sang Doubao TTS giúp giảm độ phức tạp, giảm chi phí và tăng tỷ lệ thành công.
Theo tác giả, cách làm này không chỉ áp dụng cho video cưới mà còn có thể mở rộng thành các dịch vụ video AI giàu cảm xúc và có giá trị đơn hàng cao, chẳng hạn video dành cho người lớn tuổi, trẻ nhỏ, kỷ niệm gia đình hay những dịp quan trọng khác.
Bản dịch đầy đủ
Dạo trước có một video cưới làm bằng AI lan truyền khắp Internet. Tôi thấy đây là một dự án khởi nghiệp AI rất hay. Đúng lúc trong nhà tôi có người thân làm trong ngành cưới, nên tôi chủ động liên hệ với họ và bắt đầu làm dịch vụ tùy chỉnh này.
https://x.com/gkxspace/status/2087745161564492144?s=20
Trước đây, cả trong và ngoài Trung Quốc, phần lớn những bên làm mảng này vẫn làm theo dạng hoạt hình. Ví dụ như dịch vụ Custom Love Story ở nước ngoài:
Giá mỗi đơn từ 49 USD trở lên, đã bán hơn 40.000 đơn, doanh thu vượt 2 triệu USD.
Skill của tôi thì làm theo hướng người thật, hiệu quả tốt hơn. Hiện tại tôi đã có thể vận hành ổn định toàn bộ quy trình này, đồng thời đóng gói thành một Skill có hướng dẫn để mọi người sử dụng thuận tiện hơn.
Phần tương tác với khách hàng vốn rắc rối nhất, tôi cũng đã làm thành một phiếu thu thập câu chuyện. Cô dâu chú rể chỉ cần điền theo yêu cầu, sau đó bấm sao chép một lần rồi gửi lại là xong.
Chất lượng video hoàn chỉnh đại khái như thế này:
Skill hoạt động theo kiểu hướng dẫn từng bước.
Sau khi cặp đôi điền xong phiếu thu thập, chúng ta đưa thông tin liên quan và ảnh vào cuộc hội thoại với Skill. Nó sẽ tiếp tục hướng dẫn chúng ta làm kịch bản, phần thuyết minh và phân cảnh.
Những phần cần tạo ở bên ngoài, Skill sẽ chuẩn bị sẵn prompt và tư liệu cần thiết.
Sau khi chúng ta tạo xong ảnh, video và các tài nguyên khác thì đưa ngược trở lại để Skill tiếp tục ghép thành phẩm.
Những chỗ cần duyệt nội dung, nghe thử hoặc xem kết quả, nó sẽ dừng lại để chúng ta xác nhận.
Nói trước một chút
Khuyến nghị sử dụng tổ hợp model sau:
Toàn bộ phần tương tác và điều phối quy trình nên dùng một trong ba lựa chọn:
GPT 6 trong Codex
Opus 5 trong Claude Code
hoặc chế độ mạnh nhất của Kimi K3 trong WorkBuddy
Chọn một trong ba.
Tạo ảnh dùng GPT Image 2.
Video dùng OmniFlash 1.1.
Nhạc nền dùng Suno V5.5.
Phần thuyết minh dùng Doubao TTS 2.0.
Chi phí sản xuất rất thấp. Còn thu khách hàng bao nhiêu thì tùy bạn thương lượng.
Phần tốn tiền nhất là Omni. Trên Xianyu (闲鱼) có các dịch vụ API trung gian, giá khoảng 0,5 RMB cho 10 giây. Một video 120 giây, kể cả tính thêm lượng nội dung phải tạo lại để thử nhiều lần thì tổng chi phí cũng không vượt quá khoảng 15 RMB.
Nếu bạn đã có Gemini Pro, sử dụng Google Flow thì gần như không tốn thêm tiền.
Phần tốn nhiều nhất thực ra là thời gian giao tiếp.
Vì vậy tôi làm phiếu thu thập thông tin để có thể thu thập đầy đủ mọi thứ một lần rồi bắt đầu sản xuất, đồng thời đưa toàn bộ quá trình tương tác ở từng bước vào trong Skill.
Nhờ vậy chất lượng tương đối ổn định, hiệu suất giao tiếp cao, đồng thời thuận tiện để liên tục nhận đơn và sản xuất hàng loạt.
Cách tư duy này thực ra có thể áp dụng cho rất nhiều loại dịch vụ tại địa phương.
Tôi thấy video AI là một điểm khởi đầu rất tốt, có thể làm những dịch vụ tùy chỉnh vừa có giá trị đơn hàng cao, vừa có giá trị cảm xúc.
Ngoài đám cưới, còn có người lớn tuổi, trẻ nhỏ và nhiều khoảnh khắc quan trọng đáng lưu niệm khác. Tất cả đều có thể phát triển theo hướng này.
Omni là công cụ cốt lõi của toàn bộ hệ thống này.
Toàn bộ quy trình có tổng cộng 14 bước.
Trong mỗi lần trò chuyện, nó sẽ cho bạn biết hiện tại đang ở bước thứ mấy, còn bao nhiêu bước và lúc này bạn cần làm gì.
Những chỗ cần bạn tự đánh giá, nó sẽ dừng lại chờ bạn xác nhận. Sau khi xác nhận xong mới tiếp tục.
Hiện tại tôi đã chạy trọn vẹn một vòng hoàn chỉnh. Tổng thời gian cần con người trực tiếp can thiệp có thể kiểm soát trong vòng 1 giờ.
Dưới đây tôi sẽ chia sẻ các model được sử dụng và quy trình cụ thể.
Nếu có vấn đề, mọi người có thể trao đổi trong nhóm Douyin của tôi:
【大雷的AI日记 – Nhật ký AI của Đại Lôi】
Sau này tôi cũng sẽ đăng video hướng dẫn đầy đủ để dẫn mọi người chạy toàn bộ quy trình một lần.
Lệnh cài đặt Skill
Sao chép đoạn sau cho Codex:
安装Skill。Skill位于仓库根目录,安装名使用 wedding-video-guided-wizard。安装完成后告诉我下一轮如何启动,并严格按照Skill的14步流程,主动引导我推进婚礼视频制作。请从aaronyi97/wedding-video-guided-wizard
Nội dung tiếng Việt:
Cài đặt Skill. Skill nằm trong thư mục gốc của kho mã nguồn, dùng tên cài đặt là wedding-video-guided-wizard.
Sau khi cài đặt xong, hãy cho tôi biết ở lượt tiếp theo phải khởi động như thế nào, đồng thời tuân thủ nghiêm ngặt quy trình 14 bước của Skill và chủ động hướng dẫn tôi thực hiện quá trình sản xuất video cưới.
Hãy cài đặt từ:
aaronyi97/wedding-video-guided-wizard
Sau khi cài đặt hoàn tất, ở lượt tiếp theo hãy nói với nó:
使用 wedding-video-guided-wizard 开始一单婚礼视频。先给我能发给新人的故事采集卡,再逐步带我完成。
Nội dung:
Dùng wedding-video-guided-wizard để bắt đầu một đơn video cưới.
Trước tiên hãy đưa cho tôi phiếu thu thập câu chuyện có thể gửi cho cô dâu chú rể, sau đó từng bước dẫn tôi hoàn thành toàn bộ quy trình.
Phần tương tác cụ thể có thể thực hiện trực tiếp trong Skill. Các bước chi tiết bên dưới chủ yếu dùng để giúp mọi người hiểu quy trình.
1. Trước tiên gửi phiếu thu thập câu chuyện cho cặp đôi
Sau khi cài Skill, ở bước đầu tiên nó sẽ đưa cho bạn một phiếu thu thập câu chuyện.
Bạn chỉ cần gửi phiếu này cho cô dâu chú rể điền.
Khuyến nghị dùng máy tính, nhưng điện thoại cũng được.
Mở Wedding Story Collection Card.
Sau khi điền xong, yêu cầu họ bấm:
“Copy full story card”
Sau đó gửi nội dung qua WeChat cho bạn.
Ảnh của hai nhân vật thì gửi riêng.
Tiếp theo bạn đưa toàn bộ thông tin và ảnh này trở lại cuộc hội thoại đang chạy Skill lúc nãy.
Nếu cặp đôi không tiện tự điền, bạn cũng có thể thu thập toàn bộ thông tin trong phiếu bằng cách nhắn tin hoặc nói chuyện bằng giọng nói, sau đó đưa cho Skill sắp xếp lại.
Phần tương tác phiền phức nhất, tôi chủ yếu giải quyết ngay ở bước này.
Những thông tin đã ghi rõ thì về sau không cần hỏi lại nữa.
Chỉ có một vài điểm chưa nói rõ nhưng có ảnh hưởng đến việc viết kịch bản thì mới cần hỏi bổ sung.
2. Tạo gói nội dung viết và đưa cho Kimi K3
Sau khi đã đủ thông tin, Skill sẽ dựa trên câu chuyện của cặp đôi này để tạo một gói nội dung viết.
Nó sẽ cung cấp một file nén. Trong đó cũng có một file văn bản hoàn chỉnh có thể sao chép trực tiếp sang Kimi K3.
Những trải nghiệm mà cặp đôi cung cấp, phong cách họ muốn, thời lượng video, cùng với yêu cầu về cách viết kịch bản đều đã được sắp xếp sẵn bên trong.
Tôi vẫn rất khuyến nghị mọi người dùng Kimi K3 để viết kịch bản.
Bạn có thể đưa cả gói nội dung viết cho nó, hoặc mở file sao chép nhanh bên trong rồi sao chép toàn bộ nội dung sang Kimi.
Sau khi Kimi viết xong, sao chép toàn bộ kết quả trở lại cuộc hội thoại Skill hiện tại.
Với đơn lần này, phong cách kịch bản tôi muốn là:
Có cảm xúc, có chất văn nhưng không quá hoa mỹ, đồng thời cũng không quá khô khan.
Nói cách khác là kiểu bạch miêu (白描) — kể một cách giản dị, trực tiếp, nhưng đọc lên vẫn có cảm xúc và kể được câu chuyện của hai người.
Tôi đã đưa những phương pháp viết này vào trong Skill.
Tuy nhiên, nội dung cụ thể của từng đơn vẫn phải dựa trên phiếu thu thập câu chuyện mà cặp đôi đó đã điền.
Không thể lấy trải nghiệm của cặp đôi trước rồi bê nguyên sang cặp sau.
Sau khi nhận lại kịch bản, trước tiên bạn tự đọc toàn bộ một lượt, rồi cùng Skill chỉnh những chỗ có vấn đề.
3. Gửi kịch bản cho cặp đôi xác nhận
Sau khi bạn đã tự xem lại và thấy không có vấn đề rõ ràng, hãy gửi toàn bộ kịch bản cho cặp đôi.
Bước này chủ yếu để họ xác nhận:
Có chi tiết trải nghiệm nào bị viết sai không?
Cách xưng hô có vấn đề không?
Có nội dung nào họ không muốn đưa vào video không?
Cách diễn đạt cuối cùng có đúng với điều họ muốn không?
Nếu có yêu cầu sửa, mang phản hồi trở lại cuộc hội thoại hiện tại rồi tiếp tục chỉnh.
Sau khi cặp đôi xác nhận không còn vấn đề, hãy nói với Skill rằng bản kịch bản này đã được duyệt, sau đó mới bước vào phần sản xuất phía sau.
Tôi cố ý đặt bước này khá sớm.
Câu chuyện phải được xác nhận rõ trước, sau đó phần thuyết minh, tạo ảnh và video đều xoay quanh phiên bản kịch bản này.
4. Trước tiên tạo vài mẫu giọng để nghe thử và chọn chất giọng
Tiếp theo là phần thuyết minh.
Tôi khuyến nghị Doubao TTS 2.0.
Nếu trước đây bạn đã cấu hình API rồi thì dùng tiếp luôn.
Nếu chưa từng cấu hình, Skill sẽ hướng dẫn bạn đăng ký và thiết lập ngay tại bước này. Không cần chuẩn bị hết mọi thứ ngay từ đầu.
Vào Doubao Voice Console.
Trước tiên chọn một đoạn ngắn từ kịch bản đã được duyệt, sau đó tạo khoảng 3–5 giọng khác nhau để nghe thử.
Dùng cùng một đoạn nội dung cho tất cả các giọng để dễ nghe ra sự khác biệt.
Ở vòng này, trước hết chọn một giọng phù hợp với câu chuyện.
Sau đó cùng xác nhận cảm xúc và tốc độ nói.
Chỗ nào nghe không tự nhiên thì nói trực tiếp cho Skill rồi tiếp tục điều chỉnh.
5. Tạo toàn bộ phần thuyết minh và tự nghe từ đầu đến cuối
Sau khi đã chọn giọng, dùng các thiết lập vừa xác định để tạo toàn bộ phần thuyết minh.
Tạo xong phải tự nghe từ đầu đến cuối một lần.
Kiểm tra:
Có chữ nào đọc sai không?
Có thiếu câu không?
Có lặp câu không?
Cảm xúc có phù hợp không?
Khoảng nghỉ có tự nhiên không?
Có vấn đề ở đâu thì sửa đúng chỗ đó rồi nghe lại.
Chỉ sau khi xác nhận toàn bộ phần thuyết minh không còn vấn đề mới chuyển sang phân cảnh.
Bởi vì về sau mỗi hình nên xuất hiện bao lâu, lúc nào chuyển cảnh đều phải dựa trên phần thuyết minh thực tế.
Do đó phải làm âm thanh trước rồi mới chia cảnh.
6. Dựa trên kịch bản và phần thuyết minh thực tế để thiết kế phân cảnh
Khi đã có kịch bản cuối cùng và toàn bộ phần thuyết minh, Skill sẽ bắt đầu thiết kế phân cảnh.
Trong bảng phân cảnh sẽ sắp xếp rõ:
Mỗi cảnh tương ứng với đoạn thuyết minh nào.
Xuất hiện những nhân vật nào.
Đó là giai đoạn nào trong câu chuyện.
Mặc trang phục gì.
Trong hình cần xảy ra việc gì.
Phong cách hình ảnh cũng phải dựa trên yêu cầu trong phiếu thu thập câu chuyện.
Lần này tôi làm theo hướng người thật, và dùng ảnh của chính cặp đôi làm ảnh tham chiếu nhân vật.
Tư duy của tôi là:
Hình phải đẹp, nhưng hành động không cần quá khó.
Mỗi cảnh chỉ cần truyền đạt rõ điều nó cần kể, đồng thời giữ tính nhất quán về nhân vật và chất lượng hình ảnh tổng thể là được.
Nếu một cảnh quá phức tạp thì chia thành vài cảnh nhỏ dễ làm hơn.
Câu chuyện vẫn là câu chuyện đó, nhưng về mặt sản xuất thì cố gắng làm đơn giản nhất có thể.
Sau khi bảng phân cảnh được tạo, bạn tự xem một lượt.
Xác nhận nội dung hình ảnh và phong cách tổng thể rồi mới tiếp tục tạo ảnh.
7. Trước tiên tạo ảnh cho 3 phân cảnh quan trọng
Ở bước này không tạo toàn bộ ảnh ngay lập tức.
Skill sẽ dựa vào đặc điểm của đơn hiện tại để chọn khoảng 3 phân cảnh dễ xảy ra lỗi nhưng cũng đại diện tốt cho chất lượng tổng thể.
Sau đó nó cung cấp prompt tạo ảnh và hướng dẫn về ảnh tham chiếu.
Ba cảnh này không cố định.
Phải tùy câu chuyện của cặp đôi và xem lần sản xuất này điểm khó về hình ảnh nằm ở đâu.
Bạn lấy ảnh tham chiếu nhân vật tương ứng và prompt, sau đó sang một cuộc hội thoại GPT bên ngoài, dùng GPT Image 2 để tạo ảnh.
Ở đây phải dùng cách ảnh + prompt để tạo ảnh từ ảnh (image-to-image), đặc biệt khi hai người cùng xuất hiện thì cần đảm bảo mỗi ảnh tham chiếu được gán chính xác với từng nhân vật.
Toàn bộ phần tạo ảnh của Skill này đều do bạn thao tác trong cuộc hội thoại GPT bên ngoài.
Skill chịu trách nhiệm chuẩn bị prompt và yêu cầu về ảnh tham chiếu.
Tạo xong thì gửi ảnh gốc trở lại.
Trước tiên kiểm tra:
Nhân vật có giống không?
Phong cách hình ảnh có đúng không?
Hình có lỗi rõ ràng gì không?
Sau khi vài ảnh này được duyệt mới tiếp tục làm phần còn lại.
8. Tạo toàn bộ ảnh phân cảnh còn lại
Sau khi 3 ảnh đầu được xác nhận, Skill sẽ tiếp tục dựa trên nhân vật và phong cách hình ảnh đã được xác định để cung cấp prompt cho các phân cảnh còn lại.
Bạn vẫn lấy ảnh tham chiếu phù hợp cùng prompt sang GPT để tạo.
Sau khi hoàn thành, gửi ảnh gốc trở lại theo số thứ tự cảnh.
Khi toàn bộ ảnh đã quay lại, Skill sẽ kiểm tra cả bộ hình ảnh một lần nữa.
Bạn cũng tự xem:
Cùng một nhân vật trước sau có bị thay đổi không?
Trang phục có giữ được tính liên tục không?
Các cảnh có nối với nhau được không?
Phong cách hình ảnh có nhất quán không?
Nếu chỉ có một vài ảnh không phù hợp thì sửa đúng những ảnh đó.
Sau khi sửa xong, xác nhận mỗi cảnh cuối cùng sẽ dùng hình nào rồi mới bước vào tạo video.
9. Mang gói nội dung của từng cảnh đi tạo video
Sau khi ảnh được duyệt, Skill sẽ dựa trên ảnh thực tế đã được chọn để viết prompt tạo video từ ảnh tương ứng.
Bước này tôi cố ý đóng gói thành một gói file.
Mỗi phân cảnh có một thư mục riêng.
Bên trong gồm:
Ảnh phân cảnh.
Prompt video tương ứng.
Bạn mở thư mục của một cảnh, tải ảnh lên vị trí khung hình đầu tiên (first frame) của model video.
Sau đó sao chép prompt vào.
Đặt thời lượng và tỷ lệ khung hình theo hướng dẫn rồi bấm tạo.
Về video, tôi khuyến nghị Omni.
Nếu bạn đã cấu hình được API video có thể sử dụng thì cũng có thể tiếp tục chạy ngay trong cuộc hội thoại hiện tại.
Nếu không có API, chỉ cần mang gói file này sang công cụ bên ngoài để tạo.
Xong rồi gửi video trở lại.
Prompt video ở đây được viết dựa trên ảnh thực tế đã tạo.
Nhân vật trong ảnh hiện đang ở trạng thái nào thì hành động tiếp theo sẽ bắt đầu từ đúng trạng thái đó.
Sau khi tạo, xem từng đoạn video một.
Kiểm tra:
Nhân vật có bị thay đổi không?
Hành động có thực hiện đúng không?
Nó có đúng với nội dung mà cảnh muốn truyền đạt không?
Nếu chỉ một vài cảnh có vấn đề, chỉnh prompt của đúng cảnh đó.
Hoặc quay lại sửa ảnh tương ứng rồi tạo lại.
Sau khi xác nhận ổn, gửi những video đã chọn trở lại cuộc hội thoại theo số cảnh.
10. Trước tiên nghe thử nhạc nền và chọn phong cách phù hợp
Sau khi các tài nguyên hình ảnh đã được duyệt mới bắt đầu làm nhạc nền.
Lần này tôi khuyến nghị Suno V5.5.
Bạn có thể dùng API âm nhạc đã cấu hình.
Hoặc để Skill tạo prompt rồi sang công cụ bên ngoài tạo, sau đó gửi âm thanh trở lại.
Trước tiên tạo khoảng 3 bản nhạc nền với phong cách khác nhau để nghe xem loại nào phù hợp nhất với câu chuyện của cặp đôi.
Theo tôi ở đây không thể chỉ nghĩ xem bản nhạc khi nghe riêng có hay hay không.
Phải kết hợp với diễn tiến của câu chuyện trong phần thuyết minh.
Khi câu chuyện phát triển, âm nhạc cũng phải có những cao trào và chuyển biến tương ứng.
Vòng này trước tiên chỉ cần xác định phong cách âm nhạc.
11. Nghe thử một vài đoạn có thuyết minh và nhạc nền cùng nhau
Sau khi chọn phong cách âm nhạc, để Skill ghép nhạc với phần thuyết minh đã được duyệt và tạo vài đoạn mẫu để nghe thử.
Bước này chủ yếu để nghe xem khi hai thứ đi cùng nhau thì hiệu quả thế nào.
Khi đang có lời thuyết minh:
Nhạc có quá to không?
Khi cảm xúc tăng lên, nhạc có theo kịp không?
Các khoảng nghỉ và chuyển đoạn nghe có tự nhiên không?
Chỗ nào không phù hợp thì chỉnh ngay ở vòng này.
Nếu các đoạn mẫu nghe không có vấn đề, sau khi bạn xác nhận mới tiếp tục làm toàn bộ bản phối.
Tôi cố ý dành hẳn một bước riêng cho việc nghe thử này vì muốn nghe thật rõ hiệu quả khi giọng đọc và âm nhạc kết hợp với nhau trước.
12. Tạo bản phối hoàn chỉnh giữa thuyết minh và nhạc nền
Sau khi đoạn mẫu được duyệt, dùng đúng nhạc và cách phối vừa chọn để hoàn thành toàn bộ bản âm thanh.
Tiếp tục dùng phần thuyết minh đã được xác nhận từ trước và ghép toàn bộ nhạc nền vào.
Khi có người đang nói, giảm âm lượng nhạc cho phù hợp.
Ở những khoảng phần thuyết minh tạm nghỉ, có thể đẩy nhạc lên một chút.
Sau khi hoàn thành, nghe lại toàn bộ từ đầu đến cuối.
Chủ yếu kiểm tra:
Cảm xúc tổng thể có liền mạch không?
Chuyển đoạn âm nhạc có tự nhiên không?
Phần kết có tự nhiên không?
Lời thuyết minh có nghe rõ không?
Sau khi toàn bộ phần âm thanh được duyệt thì có thể bước vào khâu ghép thành phẩm cuối cùng.
Phần thuyết minh và âm nhạc cũng sẽ được lưu riêng để sau này nếu cần sửa vẫn có thể tiếp tục sử dụng.
13. Ghép video, thêm phụ đề và xem toàn bộ bản xem trước
Khi các đoạn video, phần thuyết minh và nhạc nền đều đã chuẩn bị xong, để Skill tiếp tục ghép thành phẩm ngay trong cuộc hội thoại hiện tại.
Nó sẽ dựa trên phân cảnh đã được duyệt và phần thuyết minh thực tế để:
Xếp các đoạn video theo thứ tự.
Căn hình ảnh với âm thanh.
Thêm phụ đề tiếng Trung.
Tạo một bản xem trước hoàn chỉnh.
Nếu máy tính hiện tại thiếu công cụ cần thiết để biên tập, nó sẽ hướng dẫn bạn bổ sung ở bước này rồi tiếp tục chạy.
Sau khi bản xem trước được tạo, tự xem toàn bộ một lần.
Kiểm tra trong tổng thể cả video:
Nhân vật trước sau có bị thay đổi không?
Nội dung thuyết minh có khớp với hình ảnh không?
Phụ đề có lỗi không?
Nhạc và các đoạn chuyển cảnh có tự nhiên không?
Nếu phát hiện vấn đề, nói chính xác cảnh hoặc mốc thời gian cho Skill.
Nó sẽ sửa phần tương ứng.
Sau khi chỉnh xong xem lại.
Chỉ khi xác nhận không có vấn đề mới xuất bản cuối cùng.
14. Xuất thành phẩm và gửi cho cặp đôi xác nhận
Bước cuối cùng là xuất video hoàn chỉnh, đồng thời sắp xếp file phụ đề và các tư liệu dự án cần dùng nếu sau này phải chỉnh sửa.
Bạn kiểm tra lại bản xuất cuối cùng trước.
Sau đó gửi video hoàn chỉnh cho cặp đôi.
Nếu họ xem xong có phản hồi thì mang phản hồi trở lại để chỉnh.
Chỉ khi họ xác nhận không còn vấn đề thì đơn này mới được xem là hoàn thành.
Toàn bộ quy trình cơ bản là như vậy.
Cặp đôi chủ yếu tham gia ở:
Phần điền thông tin ban đầu.
Xác nhận kịch bản.
Xác nhận video hoàn chỉnh.
Phần xem lại kịch bản, nghe thử âm thanh, xem ảnh và kiểm tra video ở giữa sẽ do phía sản xuất chúng ta xử lý.
Khi mọi người sử dụng thực tế, chỉ cần đi theo từng bước mà Skill đang hướng dẫn.
Nó sẽ nói cho bạn biết hiện tại đang ở đâu, cần gửi lại thứ gì.
Sau khi bạn xác nhận xong, nó mới dẫn tiếp sang bước kế tiếp.
Một vài câu hỏi thường gặp
1. Tại sao dùng thuyết minh để kể chuyện thay vì cho nhân vật trực tiếp nói tiếng Trung?
Bởi vì quy trình của tôi sử dụng Omni.
Lý do chính tôi chọn nó là chi phí và chất lượng hình ảnh.
Nhưng theo trải nghiệm sử dụng thực tế của tôi, khả năng tạo hội thoại tiếng Trung của nó vẫn chưa đủ ổn định.
Nếu còn yêu cầu nhân vật mở miệng nói thì độ phức tạp của toàn bộ quá trình sản xuất sẽ tăng lên rất nhiều.
Phần thuyết minh có thể làm riêng rất ổn bằng Doubao.
Hình ảnh chỉ cần đảm nhiệm việc thể hiện câu chuyện.
Cách này đã đạt được hiệu quả tôi muốn, đồng thời dễ kiểm soát chi phí và tỷ lệ thành công hơn.
Không cần ngay từ đầu đã tự tăng độ khó cho quy trình.
2. Chi phí 15 RMB được tính như thế nào?
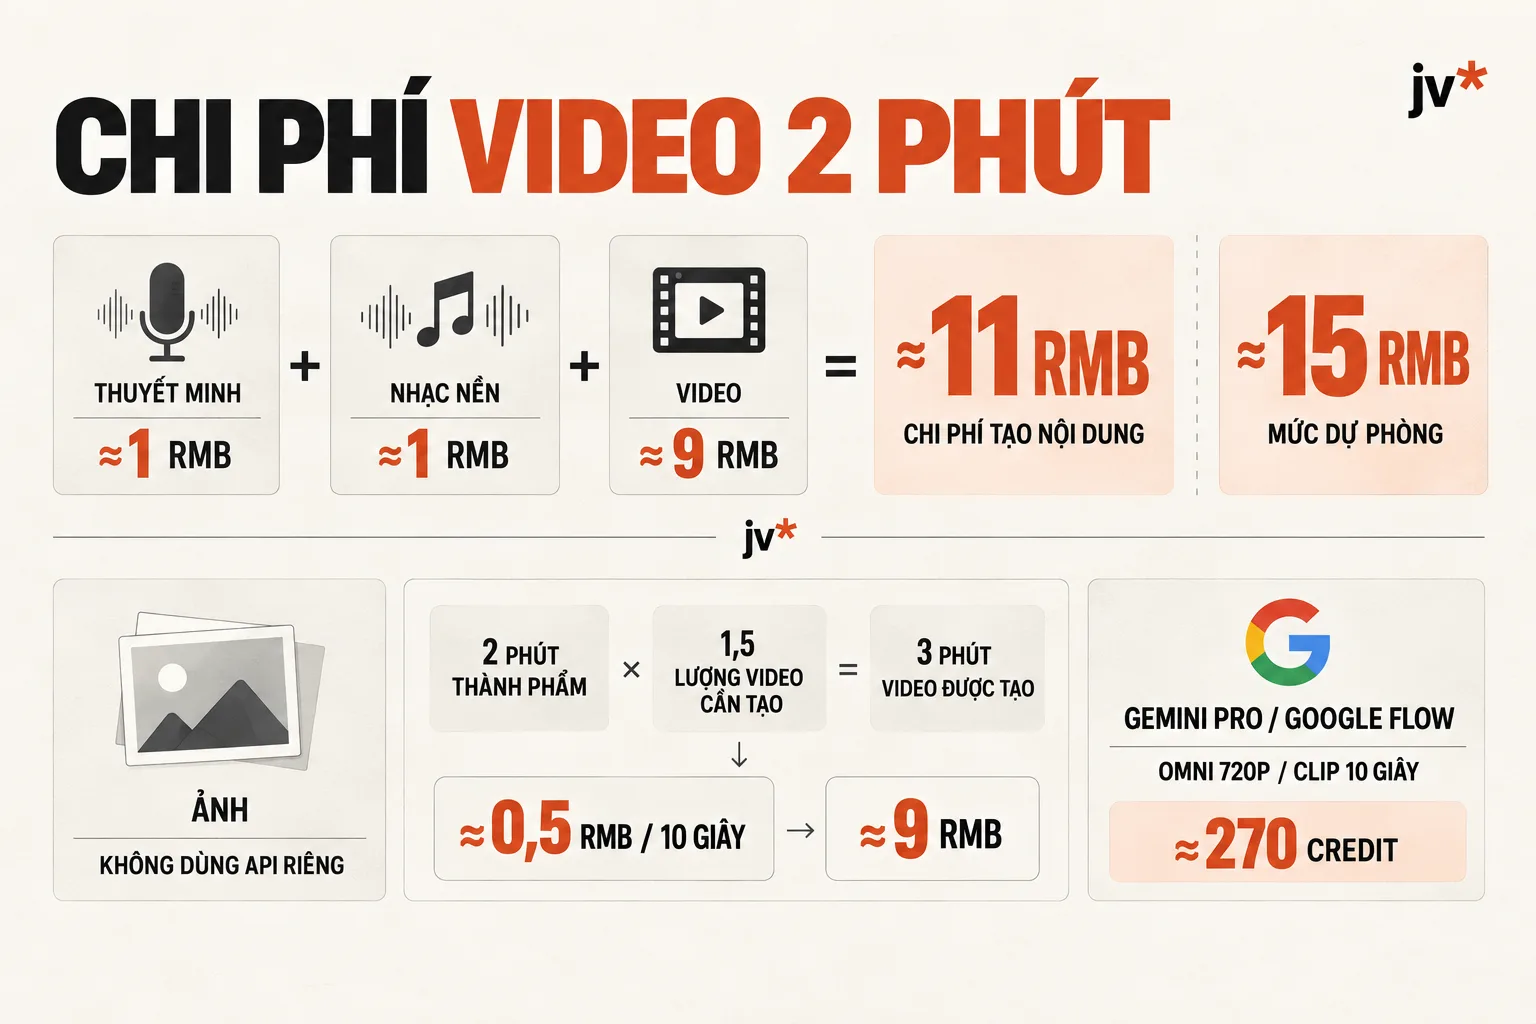
Con số tôi nói ở đây là chi phí tạo nội dung, tính theo mức giá API trung gian mà tôi đang sử dụng.
Phần thuyết minh khoảng 1 RMB.
Nhạc nền khoảng 1 RMB.
Ảnh được tạo ngay trong cuộc hội thoại GPT trên web nên tôi không sử dụng API tạo ảnh riêng.
Số lượng phân cảnh cũng không nhiều, tôi thấy không đáng để dùng API riêng chỉ để tạo ảnh.
Khoản chính là video.
Giá API trung gian tôi tìm được khoảng:
0,5 RMB / 10 giây
Trên Xianyu cũng có những dịch vụ dạng này.
Với video 2 phút, giả sử tổng lượng video phải tạo bằng 1,5 lần độ dài video hoàn chỉnh, thì phần video khoảng 9 RMB.
Cộng thêm phần thuyết minh và nhạc nền thì khoảng 11 RMB.
Tôi thường dự phòng tổng khoảng 15 RMB.
Nếu đã có gói Gemini Pro, cũng có thể sử dụng credit của Google Flow.
Tính theo Omni 720p, mỗi đoạn 10 giây và cũng dự phòng tổng thời lượng cần tạo bằng 1,5 lần độ dài video hoàn chỉnh:
Một video 2 phút cần khoảng 270 credit.
Nếu hạn mức trong gói đăng ký đủ dùng thì không phải trả thêm chi phí tạo video này.
Như vậy cả video gần như không phát sinh thêm chi phí.
3. Nếu cứ phải “抽卡” — tạo đi tạo lại để cầu may — thì làm sao?
Theo đánh giá của tôi, nếu phải liên tục “抽卡” — tạo lại nhiều lần để cầu may — thì phần lớn phải quay lại kiểm tra ba thứ:
Ảnh phân cảnh.
Prompt tạo video từ ảnh.
Model video đang sử dụng.
Nếu tư thế trong ảnh ban đầu không phù hợp với hành động phía sau, đồng thời prompt lại yêu cầu hoàn thành quá nhiều việc trong một lần tạo, thì rất dễ xảy ra lỗi.
Vì vậy tôi đã hệ thống toàn bộ những phương pháp sản xuất này vào Skill:
Trước tiên xác nhận phân cảnh.
Sau đó thử tạo ảnh.
Rồi dựa trên ảnh thực tế để viết prompt video.
Cảnh nào có vấn đề thì quay về đúng công đoạn tương ứng để chỉnh.
Cũng chính vì vậy tôi rất khuyến nghị mọi người trước tiên sử dụng đúng tổ hợp model mà tôi đề xuất để chạy trọn vẹn quy trình.
Phần kịch bản giao cho Kimi K3.
Phần điều phối toàn bộ quy trình dùng những model tôi đề xuất ở đầu bài.
Nếu muốn tái tạo kết quả mà tôi đạt được lần này thì trước tiên cứ chạy đúng bộ công cụ này.
Trong quá trình sử dụng nếu gặp vấn đề, mọi người có thể phản hồi cho tôi.
Tôi sẽ tiếp tục chia sẻ những bài hướng dẫn chi tiết nhất về các dự án kiếm tiền bằng AI.
Hoan nghênh mọi người theo dõi!